docker compose up -d는 기동을 기다리지 않는다
docker compose up -d의 종료 코드 0은 컨테이너가 살아 있다는 뜻이 아닙니다. 배포 워크플로가 healthy·로그인 로그·환경 라벨을 세 겹으로 확인하게 만들고, 그 검증 자체가 정상 배포를 실패로 오탐한 두 번을 고친 기록입니다.
Discord 봇 하나를 자체 호스팅 서버에서 docker compose 로 굴리고 있습니다.
GitHub Actions 가 사설 VPN 을 거쳐 SSH 로 들어가 docker compose up -d --build 를 치고 나오면 배포가 끝나는 구조였고, 꽤 오래 그걸로 충분했습니다.
근데 어느 날 워크플로는 초록인데 봇이 죽어 있었습니다.
"up -d 가 0 을 돌려줬으면 뜬 것 아닌가?"
결론부터 말하면, 배포 성공과 서비스 정상은 다른 말이었고, 그 사이를 워크플로가 직접 확인하게 만든 뒤에야 초록을 믿을 수 있게 됐습니다.
배포는 초록인데 봇은 죽어 있었다
처음 배포 스텝은 이게 전부였습니다.
- name: SSH and deploy
  uses: appleboy/ssh-action@v1
  with:
    script: |
      cd ~/app
      git pull origin main
      docker compose up -d --build
      docker image prune -f
재현 조건은 단순합니다.
.env 의 봇 토큰이 잘못된 채로 배포하면, 컨테이너는 뜨고 로그인에 실패하고 프로세스가 죽습니다.
restart: unless-stopped 가 다시 띄우고, 또 죽고, 또 띄웁니다.
그 사이 워크플로는 이미 초록으로 끝나 있습니다.
솔직히 이걸 몰랐던 건 아닙니다.
"배포 후에 docker compose ps 와 로그를 확인한다"는 절차가 저장소 문서에 적혀 있었습니다.
근데 사람이 매번 손으로 하는 절차는 사람이 안 보는 순간 없는 것이 됩니다.
문서에만 있는 검증은 검증이 아니었습니다.
왜 up -d 의 종료 코드는 믿을 수 없나
docker compose up -d 는 컨테이너를 만들고 시작하라는 요청을 데몬에 넘기면 할 일이 끝납니다.
그 안의 프로세스가 로그인에 성공하는지, 3초 뒤에 죽는지는 관심 밖입니다.
터미널에서 바로 확인할 수 있습니다.
docker compose up -d
echo "exit=$?"        # exit=0
sleep 3
docker compose ps     # STATUS: Restarting (1) 3 seconds ago
종료 코드 0 과 Restarting 이 같은 화면에 있습니다.
CI 는 종료 코드만 보므로 이 스텝은 언제나 초록입니다.
Compose v2 에는 --wait 옵션이 있어서 서비스가 running 또는 healthy 가 될 때까지 기다려 줍니다.
물론 이것만으로 끝나면 좋았겠지만, 아래에서 보듯 저희 healthcheck 의 "healthy" 가 실제 정상과 달라서 어차피 로그까지 보는 폴링 루프가 필요했습니다.
첫 시도: healthy 만 기다리기
당연히 healthcheck 부터 떠올렸습니다.
봇은 비밀번호 입력용 웹폼을 같은 프로세스에서 띄우고 있었으니, 그 포트가 열렸는지를 봤습니다.
healthcheck:
  test: ["CMD", "python", "-c", "import socket; s=socket.socket(); s.connect(('localhost',8080)); s.close()"]
  interval: 30s
  timeout: 5s
  retries: 3
  start_period: 30s
그리고 워크플로에서 healthy 가 될 때까지 기다리게 했습니다.
근데 토큰이 틀린 상태로 다시 배포해 보니 healthy 가 됐습니다.
이유는 순서에 있었습니다.
웹 서버는 봇이 Discord 게이트웨이에 로그인하기 전에 뜹니다.
포트는 "웹 서버가 떴다"는 신호이지 "Discord 에 붙었다"는 신호가 아닙니다.
토큰이 틀려 로그인이 영영 안 돼도 포트는 열려 있고, healthcheck 는 초록입니다.
healthy 는 필요조건이지 충분조건이 아니었습니다.
세 겹으로 확인한다
그래서 워크플로가 세 가지를 순서대로 보게 했습니다.
| 겹 | 확인 | 잡는 실패 |
|---|---|---|
| 1 | 컨테이너가 healthy | 프로세스가 죽거나 재시작 반복 |
| 2 | 로그에 로그인 완료 | 토큰 오류, 게이트웨이 연결 실패 |
| 3 | 로그에 환경: prod | 다른 환경 설정으로 기동 |
2번은 봇 코드가 on_ready 에서 찍는 한 줄에 기댑니다.
@bot.event
async def on_ready():
    logger.info("%s 로그인 완료 [env=%s]", bot.user, BOT_ENV)
3번은 기동 직후 설정을 읽고 찍는 환경: prod 입니다.
stg 와 prod 가 같은 서버의 다른 디렉터리·다른 프로젝트명으로 돌기 때문에, 디렉터리 하나를 잘못 적으면 stg 배포가 prod 를 덮어씁니다.
"prod 컨테이너가 stg 설정으로 떴다"는 healthy 로도 로그인 완료로도 안 잡히므로 라벨을 따로 봅니다.
로그를 읽는 함수는 컨테이너 시작 시각 이후만 봅니다.
왜 그래야 하는지는 다음 절에서 다룹니다.
botlog() {
  cid=$(docker compose ps -q bot)
  [ -z "$cid" ] && return 1
  since=$(docker inspect -f '{{.State.StartedAt}}' "$cid")
  docker compose logs --since "$since" bot 2>/dev/null
}
폴링 루프는 최대 180초, 5초 간격입니다.
컨테이너가 아예 사라졌으면 기다릴 이유가 없으니 바로 빠져나옵니다.
DEADLINE=$((SECONDS + 180))
OK=0
while [ $SECONDS -lt $DEADLINE ]; do
  if [ -z "$(docker compose ps -q bot)" ]; then
    echo "컨테이너가 사라졌다"
    break
  fi
  STATUS=$(docker compose ps --format '{{.Health}}' bot 2>/dev/null | head -1)
  if [ "$STATUS" = "healthy" ] && botlog | grep -q "로그인 완료"; then
    OK=1
    break
  fi
  sleep 5
done
실패하면 상태와 로그 60줄을 찍고 잡을 빨갛게 만듭니다.
그 뒤에 환경 라벨을 한 번 더 봅니다.
if [ "$OK" != "1" ]; then
  echo "::error::봇이 기동하지 않았다 (healthy + 로그인 완료 미확인)"
  docker compose ps bot || true
  docker compose logs --tail 60 bot || true
  exit 1
fi

if ! botlog | grep -q "환경: prod"; then
  echo "::error::prod 가 아닌 환경으로 기동했다"
  exit 1
fi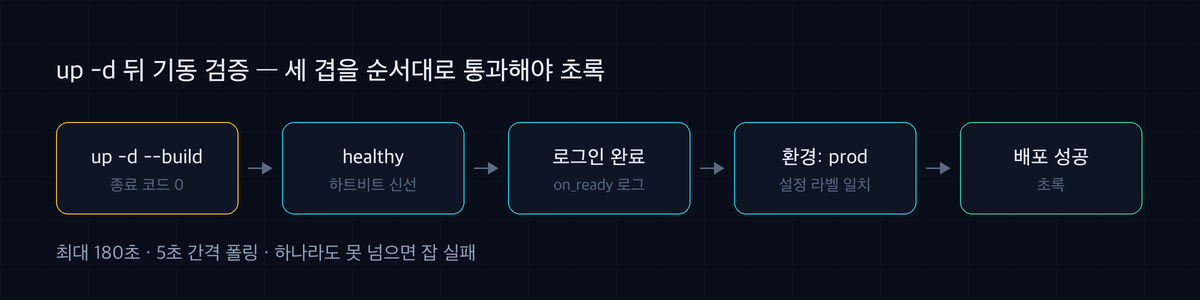
이 검증을 넣을 때 정상 컨테이너에 대해 0 이 나오는 것과, 로그인 완료가 없는 상황·환경이 다른 상황에 대해 1 이 나오는 것을 실서버에서 양방향으로 확인했습니다.
검증이 "통과" 만 확인하고 끝나면 항상 통과하는 검증인지 구별이 안 됩니다.
헤맸던 부분들 — 검증이 정상 배포를 실패로 보고했다
검증을 넣고 나서 두 번, 검증 자체가 틀렸습니다.
둘 다 정상 배포를 실패로 보고한 오탐이었습니다.
오탐은 다음부터 무시로 이어지기 때문에 놓친 실패보다 나쁩니다.
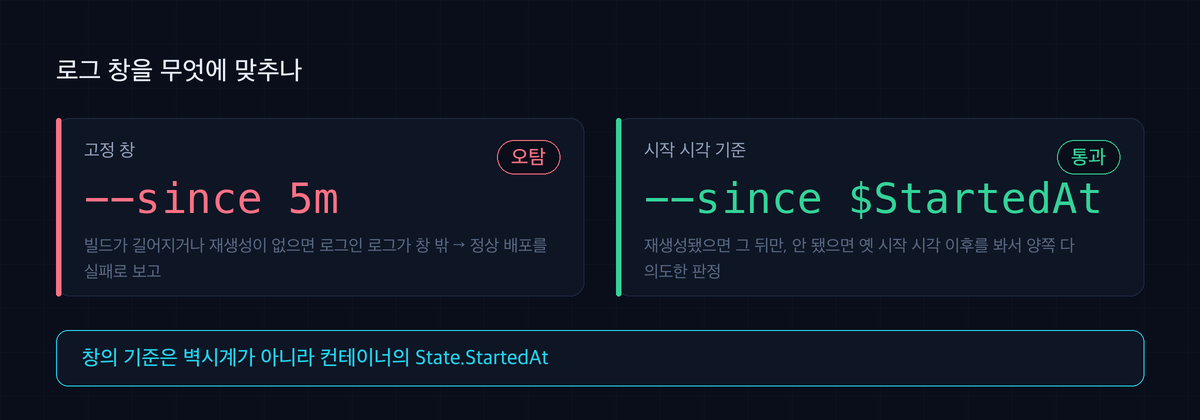
1. --since 5m 고정 창
처음에는 로그를 이렇게 읽었습니다.
# ❌ 고정 창 — 정상 prod 에 대해 0줄을 돌려줬다
docker compose logs --since 5m bot | grep -q "로그인 완료"
첫 실행에서 정상인 prod 에 대해 0줄이 나왔고, 배포가 실패로 찍혔습니다.
빌드가 5분을 넘기면 "로그인 완료" 는 창 밖으로 밀려납니다.
더 흔한 경우는 이미지 해시가 그대로라 컨테이너가 재생성되지 않는 배포입니다.
그러면 마지막 로그인 로그는 몇 시간 전 것이고, 5분 창에는 아무것도 없습니다.
그래서 창의 기준을 벽시계가 아니라 컨테이너의 State.StartedAt 으로 바꿨습니다.
# ✅ 컨테이너 시작 시각 이후만 본다
since=$(docker inspect -f '{{.State.StartedAt}}' "$cid")
docker compose logs --since "$since" bot
재생성이 안 된 컨테이너라면 시작 시각이 몇 시간 전이고, 그 이후 로그에 로그인 완료가 들어 있으므로 통과합니다.
재생성된 컨테이너라면 방금이므로 그 뒤 로그만 봅니다.
둘 다 의도한 판정입니다.
2. zsh 에서 $DC ps 는 command not found
stg 는 프로젝트명과 compose 파일이 다르므로 명령을 변수에 담았습니다.
# ❌ zsh 는 이 문자열 전체를 명령 이름 하나로 읽는다
DC="docker compose -p app-stg -f docker-compose.stg.yml"
cid=$($DC ps -q bot)
bash 라면 단어 분할이 일어나 정상 동작합니다.
근데 배포 서버의 로그인 셸은 zsh 였고, zsh 는 기본으로 변수를 단어 분할하지 않습니다.
command not found: docker compose -p app-stg ... 가 나고 cid 가 비어서, 검증은 "컨테이너가 사라졌다" 고 보고했습니다.
정상 배포가 실패로 찍힌 두 번째 오탐입니다.
처음에 이거 몰라서 한참 헤맸습니다.
로컬에서 스크립트를 검증할 때 bash 로 돌렸기 때문에 통과했고, 실제 배포에서만 깨졌습니다.
ssh-action 은 원격 계정의 로그인 셸로 스크립트를 실행하므로 서버 셸이 무엇인지부터 확인해야 합니다.
함수로 감싸면 셸이 무엇이든 같습니다.
# ✅ 함수는 "$@" 로 인자를 그대로 넘긴다
dc() {
  docker compose -p app-stg -f docker-compose.stg.yml "$@"
}
cid=$(dc ps -q bot)
고친 뒤에는 zsh 로 prod·stg 양쪽을 다시 돌려 둘 다 종료 코드 0 인 것을 확인했습니다.
검증 스크립트는 실제 배포 셸에서 검증해야 합니다.
healthcheck 를 포트에서 하트비트로
시간이 지나 봇을 역할별로 두 컨테이너로 나눴습니다.
자주 고치는 기능과, 진행 중인 작업이 재시작을 못 넘기는 기능을 분리해서 한쪽만 재배포하기 위해서였습니다.
그러자 웹폼을 띄우지 않는 쪽 컨테이너가 영원히 unhealthy 가 됐습니다.
검증은 healthy 를 요구하므로 그 컨테이너 배포는 180초 뒤 무조건 실패합니다.
"초록인데 죽음" 의 정확히 반대인 "빨간데 멀쩡함" 입니다.
포트를 보는 검사는 어차피 로그인 전에도 초록이었으니, 이 기회에 on_ready 이후에만 갱신되는 하트비트 파일로 바꿨습니다.
HEARTBEAT_INTERVAL_SECONDS = 15
STALE_AFTER_SECONDS = 60

def is_alive(data_dir, role, *, now=None, stale_after=STALE_AFTER_SECONDS):
    try:
        stamp = float(heartbeat_path(data_dir, role).read_text().strip())
    except (OSError, ValueError):
        return False
    return ((now if now is not None else time.time()) - stamp) < stale_after
봇 쪽에서는 wait_until_ready() 뒤에 시작하는 루프가 15초마다 파일을 갱신합니다.
healthcheck 는 이 모듈을 실행하고 종료 코드로 판정합니다.
healthcheck:
  test: ["CMD", "python", "-m", "bot.utils.heartbeat"]
  interval: 30s
  timeout: 5s
  retries: 3
  start_period: 60s
써 보니 파일 하나로 끝나지 않고 세부가 몇 개 붙었습니다.
1. 존재가 아니라 신선도로 판정한다
파일이 있는지만 보면 죽은 프로세스가 남긴 파일이 영원히 healthy 로 읽힙니다.
그래서 60초보다 오래된 하트비트는 실패로 봅니다.
갱신 주기 15초의 4배로 잡은 이유는, 이벤트 루프가 잠깐 밀렸다고 healthy 가 깜빡이면 배포가 헛되이 실패하기 때문입니다.
2. 파일 이름에 역할을 넣는다
두 컨테이너가 같은 데이터 볼륨을 마운트합니다.
파일 이름이 같으면 한쪽이 죽어도 다른 쪽이 갱신해 주어 양쪽 다 healthy 로 보입니다.
정확히 이 분리 작업이 만들 뻔한 사고라서 heartbeat-<역할> 로 갈랐습니다.
3. 원자적으로 쓴다
컨테이너는 재배포마다 SIGTERM 으로 죽습니다.
쓰는 도중에 죽으면 잘린 파일이 남고, 다음 검사에서 float() 가 터져 "죽었다" 로 오판하고 멀쩡한 봇을 재시작합니다.
임시 파일에 쓰고 rename 하는 방식으로 바꿨습니다.
4. start_period 는 실제 기동 시간으로 잡는다
두 번째 컨테이너는 on_ready 전에 외부 의존 준비 대기 최대 30초, 초기 데이터 조회 10초, 로그인이 순서대로 걸립니다.
최악의 경우 53초라 60초 창에 여유가 7초뿐이었습니다.
컨테이너가 죽지는 않지만 느린 날 정상 배포가 빨개지는 자리라, 이쪽만 120초로 늘렸습니다.
healthcheck 의 start_period 는 "이 시간 안의 실패는 무시한다" 는 뜻이지 "이 시간 뒤에 검사를 시작한다" 는 뜻이 아닙니다.
그 안에 성공하면 즉시 healthy 가 되므로, 넉넉히 잡아도 정상 기동이 느려지지는 않습니다.
그래도 이 검증이 못 잡는 것
솔직히 세 겹이 정상 상태를 보장하는 것은 아닙니다.
1. 재연결 중인 봇
하트비트가 보장하는 것은 "최초 로그인에 성공했고 이벤트 루프가 살아 있다" 입니다.
"지금 게이트웨이에 붙어 있다" 가 아닙니다.
discord.py 의 재연결 루프는 _ready 를 clear 하지 않아서, 끊긴 동안에도 wait_until_ready() 가 즉시 반환합니다.
그래서 루프 안에서 is_closed() 와 latency 를 함께 봅니다.
if bot.is_closed():
    return
latency = bot.latency
if latency != latency or latency == float("inf"):  # 웹소켓이 없으면 NaN
    return
heartbeat.touch()
확실히 끊긴 구간은 거르지만, 재연결을 시도하는 중까지 잡아내지는 못합니다.
2. 낡은 컨테이너
두 컨테이너 중 하나만 배포에 실패하면 다른 쪽은 옛 이미지로 계속 돕니다.
실제로 한쪽 배포가 실패한 뒤 다른 쪽이 6시간 전 이미지로 돌면서 healthy 였습니다.
증상이 없어서 기동 검증으로는 안 잡힙니다.
도는 컨테이너의 이미지 ID 와 방금 빌드된 태그의 이미지 ID 를 대조하는 게이트를 따로 뒀는데, 이건 함정이 많아 다른 글로 다루겠습니다.
3. 180초 데드라인
데드라인은 결국 "이 정도면 떴어야 한다" 는 추정입니다.
빌드가 아니라 기동이 느린 날에는 정상 배포가 빨개질 수 있습니다.
start_period 를 늘린 것과 같은 이유로, 오탐이 나면 창을 넓히되 그 근거를 주석에 남기고 있습니다.
정리
좋은 점
up -d뒤의 손 검증이 워크플로로 들어가서, 배포 초록이 실제로 "봇이 로그인했다" 를 뜻하게 됐습니다.- healthy 하나가 아니라 로그인 로그와 환경 라벨까지 보므로 토큰 오류와 환경 뒤바뀜을 배포 시점에 잡습니다.
- 하트비트 healthcheck 는 웹 서버 유무와 무관해서 컨테이너를 역할별로 나눠도 같은 방식이 통합니다.
- 오탐을 두 번 겪으면서 "검증을 실제 배포 셸에서 양방향으로 검증한다" 는 습관이 생겼습니다.
아쉬운 점
- 세 겹 검증과 하트비트 세부가 워크플로 주석으로만 남아 있어, 새 서비스를 붙일 때 옮겨 적어야 합니다.
- 하트비트는 재연결 중인 상태를 구별하지 못합니다.
- 180초·60초·120초 같은 창은 실측으로 잡은 값이라 서버가 바뀌면 다시 재야 합니다.
이미 up -d 로 배포하고 있다면 그 뒤에 healthy 만이라도 기다리게 하는 것부터 권합니다.
다만 healthcheck 가 "프로세스가 떴다" 이상을 말해 주지 않는다면, 로그의 한 줄이라도 함께 확인하는 편이 초록을 믿을 수 있게 만듭니다.
참고 자료
연관 게시글


